

Marcos Cobeña Morián
Software Development Engineer


Introducción
La inferencia de modelos de lenguaje de gran tamaño no es territorio exclusivo de la GPU. Nuestras pruebas sobre un nodo Intel Xeon 6980P demuestran que, cuando se combinan la arquitectura CPU adecuada con la tecnología de compresión de Multiverse (CompactifAI), los resultados son no solo funcionales sino sorprendentemente capaces para múltiples casos de uso reales.
Cuando se habla de inferencia de modelos de lenguaje, la conversación suele girar en torno a la GPU casi de forma automática. Es comprensible: la GPU ha dominado el entrenamiento y, por extensión, se ha convertido en la referencia mental para cualquier tarea relacionada con IA. Sin embargo, esa asociación ha generado también una subestimación de lo que una CPU moderna, bien dimensionada y explotada, es capaz de hacer en producción.
El 23 de julio de 2026 Multiverse Computing hizo pública esta noticia, en la que se mostró que los modelos comprimidos con CompactifAI, incluido Llama 3.3 70B, podían ejecutarse en procesadores Intel Xeon 6, con gran rendimiento y precisión. A partir de ese hito, este artículo aporta una validación práctica independiente sobre un nodo Intel Xeon 6980P, con varios modelos y escenarios de carga orientados a casos de uso reales.
A continuación se recogen los resultados de un ejercicio práctico y metódico: desplegar modelos de la familia Llama (Meta) sobre un único nodo CPU basado en Intel Xeon 6980P, medir su comportamiento real bajo estrés con la herramienta de benchmarking vllm bench serve y, en la versión 3.1 8B Instruct, comparar dos versiones: la original y la optimizada con la tecnología de compresión de CompactifAI (Multiverse). Los datos que se presentan a continuación no son estimaciones ni proyecciones, sino mediciones directas sobre el hardware (tampoco se han usado máquinas virtuales ni contenedores).
La conclusión que emerge de este análisis es doble. Primero, más sorprendente: el Intel Xeon 6980P ofrece una base de cómputo genuinamente capaz para LLMs en escenarios de uso reales. Segundo: la tecnología de compresión de Multiverse (CompactifAI) multiplica el rendimiento sobre esa base y, en el caso de 3.3 70B Instruct, lo habilita (el modelo original, sin optimizar, no pudo ni tan siquiera iniciarse).
Intel Xeon 6980P, un nodo con músculo real
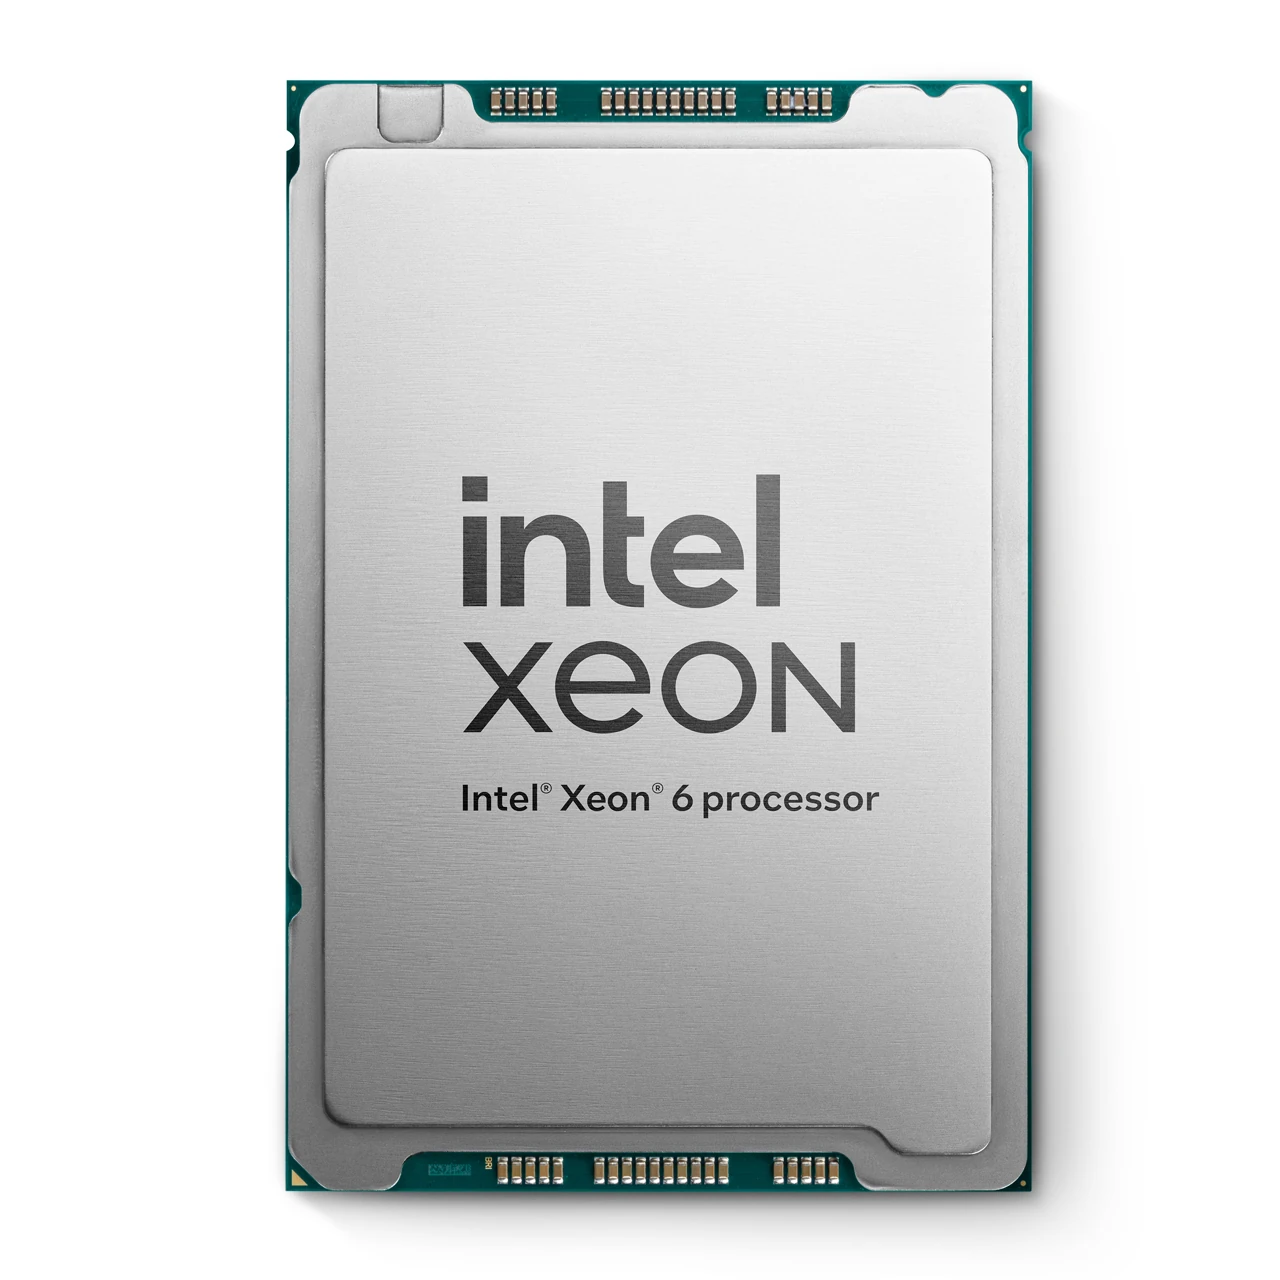
Imagen extraída de aquí el 5/8/2026
El nodo evaluado no es una máquina experimental ni un prototipo de laboratorio. El Intel Xeon 6980P es un procesador de gama alta con 2 sockets, 128 núcleos físicos por socket y 2 hilos por núcleo, lo que resulta en un total de 512 vCPU disponibles para el servidor de inferencia. La frecuencia de trabajo varía entre 800 MHz y 3.900 MHz según la carga, y la memoria RAM total disponible alcanza los 1,5 TB.
No estamos ante una máquina marginal que se queda sin recursos en el primer intento de cargar un modelo serio. Estamos ante un nodo con capacidad de memoria suficiente para alojar modelos de 8B y 70B de parámetros con holgura, y con suficientes hilos de ejecución como para atender múltiples solicitudes en paralelo. El límite no es la plataforma; es lo que se hace con ella.
El servidor de inferencia utilizado ha sido vLLM[1], la opción que Intel recomienda para extraer el máximo partido en escenarios de throughput elevado sobre arquitecturas x86. Esta elección no es casual: vLLM está diseñado específicamente para maximizar la eficiencia de los transformers a la hora de servir peticiones, y representa el estado del arte disponible para esta categoría de hardware.
Rigor reproducible con escenarios reales
Las pruebas se han ejecutado con vllm bench serve , la misma herramienta que Intel usa como referencia en su documentación pública. La configuración ha sido idéntica para todos los modelos: 200 prompts por ejecución, hasta 32 peticiones concurrentes, sin límite de tasa de envío, con longitudes de prompt e instrucción fijadas por escenario.
El diseño cubre cuatro casos de uso con raíz en necesidades reales de producción:
Chatbot (128 tokens de entrada, 128 de salida): conversaciones breves, soporte, preguntas y respuestas. La métrica clave es el tiempo hasta el primer token (TTFT), que define la percepción de respuesta inmediata.
Creación de contenido (128 de entrada, 2.048 de salida): generación de textos largos, blogs, descripciones. El foco se desplaza hacia la cadencia sostenida de generación (TPOT).
Describir (2.048 de entrada, 128 de salida): resumen, síntesis, etiquetado. Exige que el modelo procese contexto extenso antes de responder.
Corregir (2.048 de entrada, 2.048 de salida): edición prolongada, reescritura, mejora de documentos. El caso más exigente en ambas dimensiones.
De estos cuatro, los más representativos de la validación son Chatbot y Corregir, que cubren los dos extremos del espectro: respuesta conversacional rápida frente a generación sostenida de alto volumen.
Las dos métricas centrales del análisis son:
TTFT (Time To First Token): tiempo hasta que el sistema entrega el primer token al usuario. Es el indicador de fluidez percibida.
TPOT (Time Per Output Token): tiempo medio por token generado durante el resto de la respuesta. Describe la velocidad sostenida de generación.
Intel establece umbrales orientativos: TTFT máximo de 3 segundos y TPOT máximo de 100 ms para casos conversacionales, y TTFT de 10 segundos para casos de entrada larga.
Qué hace CompactifAI sobre la CPU
El escenario Chatbot es el más exigente en cuanto a percepción de latencia. Cada milisegundo cuenta cuando el usuario espera ver una respuesta aparecer en pantalla.
| Modelo | TTFT media (ms) | TPOT media (ms) | Throughput total (tok/s) |
|---|---|---|---|
| Llama 3.1 8B Instruct (original) | 1.992 | 132 | 396 |
| Llama 3.1 8B Instruct Slim (CompactifAI) | 742 | 63 | 849 |
| Llama 3.3 70B Instruct Slim (CompactifAI) | 7.769 | 531 | 99 |
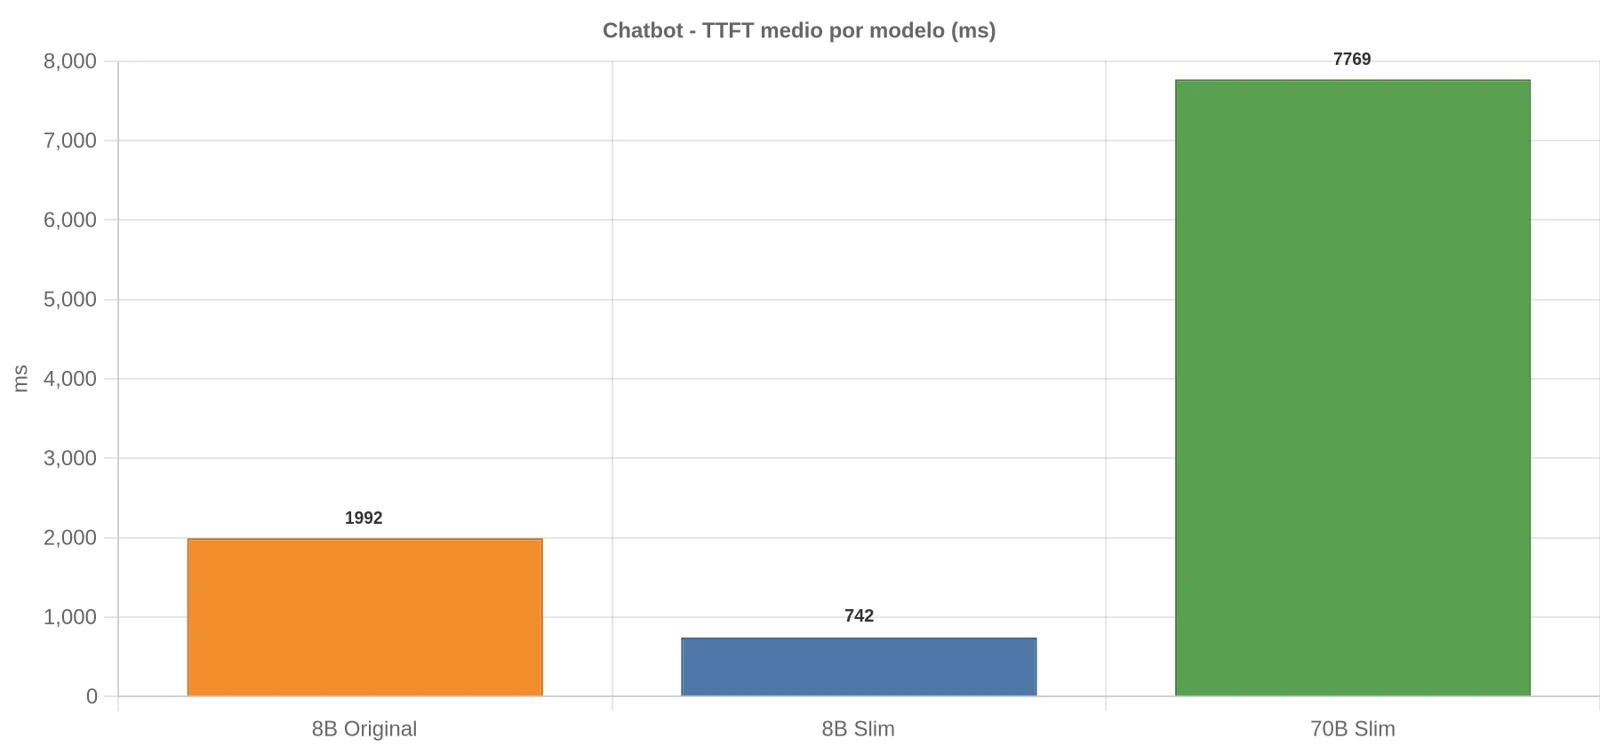
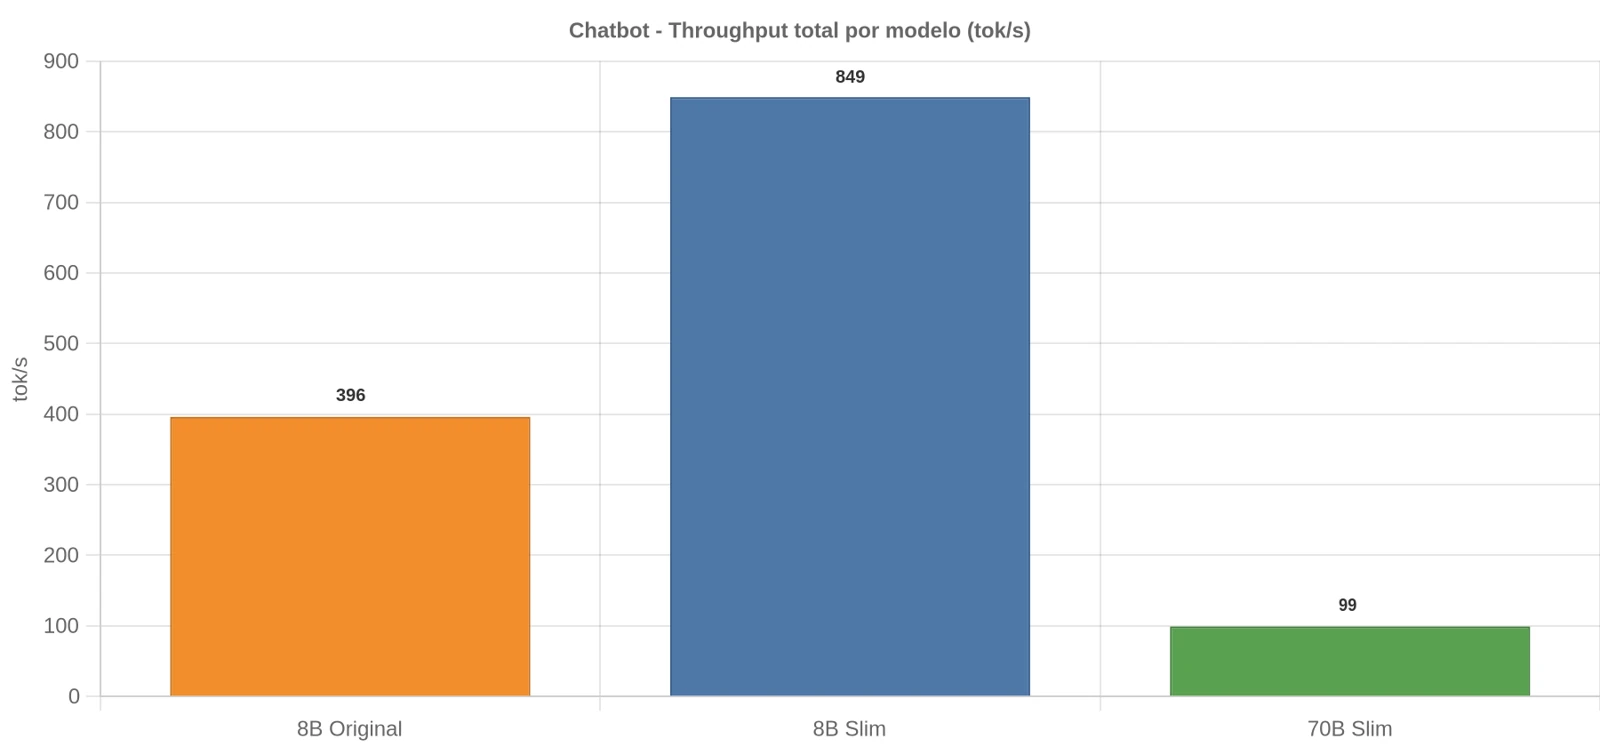
El dato más llamativo de esta tabla no es el número absoluto, sino la distancia entre la versión original y la versión optimizada con CompactifAI dentro de la misma familia de modelos y sobre el mismo hardware.
El modelo Slim de Llama 3.1 8B logra un TTFT medio de 742 ms y un TPOT de 63 ms. Esto no es solo una mejora relativa respecto al original: es un resultado que se sitúa dentro de los umbrales operativos que Intel considera aceptables para un caso conversacional (TTFT < 3.000 ms, TPOT < 100 ms). La CPU, con el modelo adecuadamente comprimido, responde en menos de un segundo y genera cada token posterior en menos de 65 ms. Eso es una experiencia de uso fluida y funcional.
La versión original del mismo modelo, sin la compresión de CompactifAI, presenta un TTFT de casi 2 segundos y un TPOT de 132 ms, que ya supera el umbral recomendado. La diferencia es de 2,69 veces en TTFT, 2,09 veces en TPOT y 2,15 veces en throughput total.
El throughput del modelo Slim alcanza 849 tokens por segundo en esta configuración. Para un servidor de inferencia atendiendo múltiples usuarios simultáneos, ese volumen tiene implicaciones directas en la capacidad de atención concurrente y en el coste operativo por solicitud.
El escenario Corregir es deliberadamente más exigente: entradas y salidas de 2.048 tokens implican que el modelo debe procesar un contexto largo antes de comenzar a generar, y después mantener la cadencia durante una respuesta extensa. Es el caso de uso más parecido a tareas de producción real en edición de documentos, revisión de código o transformación de contenido.
| Modelo | TTFT media (ms) | TTFT mediana (ms) | TPOT media (ms) | Throughput de salida (tok/s) |
|---|---|---|---|---|
| Llama 3.1 8B Instruct (original) | 7.295 | 4.227 | 211 | 139 |
| Llama 3.1 8B Instruct Slim (CompactifAI) | 2.891 | 1.693 | 130 | 229 |
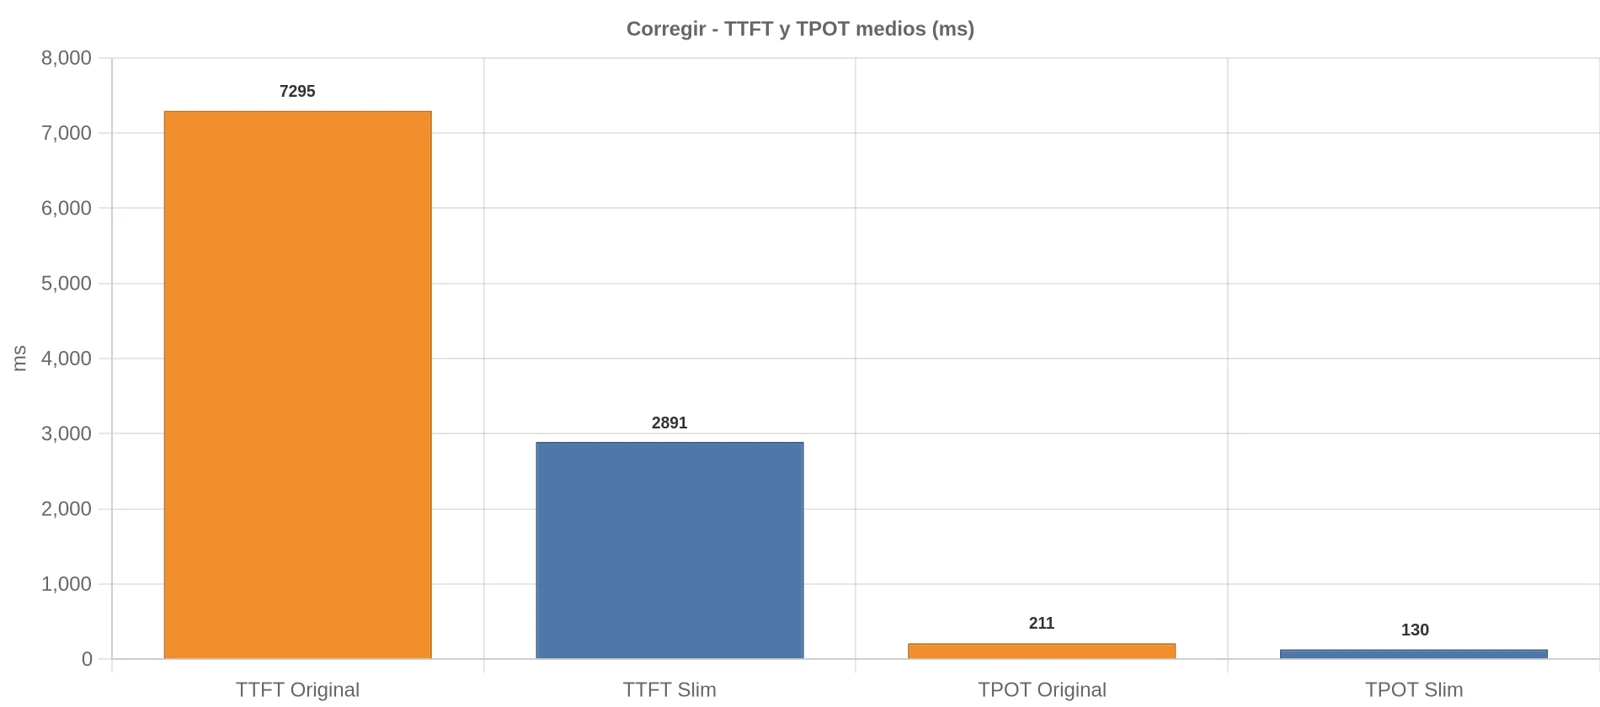
De nuevo, la tecnología de compresión de CompactifAI marca una diferencia sustancial. El modelo Slim reduce el TTFT medio en 2,52 veces respecto al original, y mejora el TPOT en 1,62 veces. El throughput de salida pasa de 139 a 229 tokens por segundo, una mejora del 65% en capacidad de generación sostenida.
Lo más significativo aquí es la mediana del TTFT. Mientras que la media puede verse afectada por valores extremos, la mediana refleja el comportamiento típico. El modelo Slim consigue una mediana de 1.693 ms frente a los 4.227 ms del original. Eso significa que en la mitad de las solicitudes, la respuesta comienza en menos de 1,7 segundos incluso para una tarea con 2.048 tokens de contexto de entrada.
Por qué la compresión de CompactifAI importa en CPU
Imagen extraída de aquí el 5/8/2026
La diferencia observada entre los modelos originales y los modelos Slim no es simplemente una reducción de tamaño que sacrifica calidad a cambio de velocidad. La tecnología de compresión de Multiverse (CompactifAI) trabaja sobre la estructura interna del modelo para reducir la carga computacional de cada token procesado, lo que se traduce en mejoras simultáneas en todas las métricas: menos tiempo hasta el primer token, menor tiempo por token generado y mayor throughput total.
Esto es especialmente relevante en el contexto de la CPU porque la arquitectura x86 impone restricciones de ancho de banda de memoria y de latencia de acceso que no existen de la misma forma en una GPU. En la GPU, la paralelización masiva permite enmascarar gran parte de esas latencias. En la CPU, cada operación tiene un coste relativo mayor, y por eso la reducción del trabajo computacional por token tiene un efecto multiplicador más pronunciado.
Los datos lo confirman: la ganancia relativa de CompactifAI sobre CPU es más pronunciada que lo que se esperaría en un entorno GPU, precisamente porque la CPU se beneficia de manera desproporcionada de cualquier reducción en la densidad computacional del modelo.
Modelos de 70B
El caso del Llama 3.3 70B Instruct Slim merece una mención específica. Un modelo de 70.000 millones de parámetros corriendo en un único nodo CPU, sin aceleradores de ningún tipo, que alcanza 99 tokens por segundo de throughput total en el escenario Chatbot, es en sí mismo un resultado que habría parecido improbable hace apenas unos años.
La versión original de Llama 3.3 70B ni siquiera completa la inicialización en las pruebas, lo que confirma que sin compresión este tamaño de modelo no es manejable en esta plataforma. Con la compresión de CompactifAI, el modelo no solo carga y opera, sino que produce resultados medibles y funcionales. El TPOT de 531 ms sitúa la experiencia fuera del rango óptimo para un chatbot interactivo de baja latencia, pero dentro de un rango perfectamente válido para casos de uso asíncronos, procesamiento por lotes, tareas de análisis o revisión de documentos donde el usuario no está esperando en tiempo real.
Este contraste es revelador: la diferencia entre un modelo que no arranca y uno que funciona a throughput aceptable es exactamente la tecnología de compresión de CompactifAI. No es un cambio de hardware, no es una optimización del sistema operativo, no es un ajuste de parámetros de serving: es el modelo el que cambia.
Casos de uso donde la CPU + CompactifAI es una opción real
Los datos permiten identificar con precisión los escenarios donde la combinación Intel Xeon 6980P + modelos Slim de CompactifAI ofrece un rendimiento operativamente razonable:
Asistencia y soporte conversacional con modelos compactos (8B Slim): con TTFT de 742 ms y TPOT de 63 ms en el escenario Chatbot, la experiencia de usuario es fluida. Estos valores cumplen los criterios que Intel establece como referencias de calidad de servicio para casos interactivos.
Edición y reescritura de documentos (8B Slim, escenario Corregir): con TTFT mediano de 1.693 ms y throughput de salida de 229 tok/s, el modelo Slim es una herramienta legítima para flujos de trabajo de productividad donde la respuesta no necesita ser instantánea pero sí razonablemente ágil.
Procesamiento por lotes y análisis asíncrono (70B Slim): para tareas que no requieren respuesta en tiempo real, el modelo de 70B con compresión produce resultados a un ritmo operativo. Tareas de análisis de documentos, generación de informes o enriquecimiento de datos son casos donde el throughput importa más que la latencia percibida.
Entornos sin GPU disponible: en organizaciones o infraestructuras donde el acceso a GPU no está garantizado o resulta costoso por disponibilidad, el Xeon 6980P con modelos CompactifAI ofrece una alternativa funcional que no requiere cambios de arquitectura.
El modelo correcto para el hardware correcto
El aprendizaje más importante de estas pruebas no es solo que la CPU puede hacer inferencia, sino cuándo y con qué modelo. La tabla de comparativa interna dentro de la familia Llama 3.1 8B es elocuente:
| Métrica | Ganancia Slim vs. original (Chatbot) | Ganancia Slim vs. original (Corregir) |
|---|---|---|
| TTFT media | 2,69x más rápido | 2,52x más rápido |
| TPOT media | 2,09x más rápido | 1,62x más rápido |
| Throughput de salida | 2,15x mayor | 1,65x mayor |
Estas ganancias son consistentes y significativas en ambos escenarios. No son artefactos de una sola condición de prueba ni dependen de parámetros específicos de configuración: emergen del mismo benchmark con la misma infraestructura, simplemente cambiando el modelo por su versión comprimida con CompactifAI.
Este patrón tiene una implicación directa para cualquier organización que esté evaluando plataformas de inferencia: la elección del modelo tiene tanto peso como la elección del hardware. Un modelo optimizado con tecnología de compresión avanzada sobre hardware CPU moderno puede superar con claridad a un modelo original sobre el mismo hardware, y esa diferencia no se recupera ajustando parámetros del servidor.
Conclusión
Las pruebas sobre el Intel Xeon 6980P dejan dos mensajes claros.
El primero, y el más revelador, es que la inferencia de modelos de lenguaje en CPU no es una idea marginal ni una solución de último recurso. Un nodo con 512 vCPU, 1,5 TB de RAM y vLLM como servidor de inferencia es una plataforma legítima y funcional para servir modelos de lenguaje. Los números lo confirman: con el modelo adecuado, la CPU entrega tiempos de respuesta y throughput que satisfacen los criterios operativos de casos de uso reales.
El segundo mensaje es que la tecnología de compresión de CompactifAI (Multiverse) mejora aún más el rendimiento de los modelos sobre CPU. Sin compresión, los modelos originales presentan latencias elevadas y throughput limitado. Con las versiones Slim de CompactifAI, el mismo hardware entrega entre 1,6 y 2,7 veces mejor rendimiento en todas las métricas principales, y además permite operar modelos de 70B de parámetros.
La CPU + CompactifAI no es solo una alternativa interesante técnicamente: es una combinación que abre casos de uso reales, en infraestructura existente, sin depender de disponibilidad de GPU. Y los datos están ahí para demostrarlo.
Un modelo Mixture-of-Experts también viable en CPU
Llama 4 Scout (Meta) introduce un cambio de arquitectura respecto a los modelos densos analizados hasta ahora: es un modelo Mixture-of-Experts (MoE), con 17B de parámetros activos por token repartidos entre 16 expertos, sobre un total aproximado de 109B de parámetros. El footprint de memoria y la complejidad del enrutamiento entre expertos son muy superiores a los de un modelo denso equivalente, aunque el cómputo activado por token se mantenga en el orden de un modelo de 17B.
Igual que ocurrió con Llama 3.3 70B Instruct, la versión original sin comprimir, meta-llama/Llama-4-Scout-17B-16E, no llegó a completar la inicialización del servidor de inferencia en este nodo. Solo la versión comprimida con la tecnología de CompactifAI pudo arrancar y servir peticiones.
| Escenario | TTFT media (ms) | TTFT mediana (ms) | TPOT media (ms) | Throughput de salida (tok/s) | Throughput total (tok/s) |
|---|---|---|---|---|---|
| Chatbot (128/128) | 3.902 | 3.603 | 536 | 53 | 105 |
| Corregir (2.048/2.048) | 12.173 | 5.872 | 938 | 32 | 64 |
Comparado con Llama 3.3 70B Instruct Slim (el otro modelo que solo resulta viable gracias a la compresión) en el escenario Chatbot, Llama 4 Scout Slim entrega un TTFT medio menos de la mitad (3.902 ms frente a 7.769 ms) y un throughput total ligeramente superior (105 frente a 99 tok/s), con un TPOT prácticamente idéntico (536 ms frente a 531 ms). Esto es coherente con su arquitectura MoE: aunque el modelo tiene muchos más parámetros totales, cada token solo activa una fracción de ellos, por lo que el coste de cómputo por token generado queda en el mismo orden que el de un modelo denso de tamaño similar al de los parámetros activos.
En el escenario Corregir, con 2.048 tokens de entrada y salida, el TPOT se dispara hasta los 938 ms, casi el doble que en Chatbot. El patrón es el mismo que se observa en los modelos densos (el TPOT de Llama 3.1 8B Instruct original pasa de 132 ms en Chatbot a 211 ms en Corregir), aquí amplificado por el coste adicional del enrutamiento entre expertos sobre secuencias largas. Con estos números, Llama 4 Scout Slim queda, igual que Llama 3.3 70B Instruct Slim, fuera del rango de un chatbot interactivo de baja latencia, y encaja mejor en escenarios de procesamiento por lotes o análisis asíncrono, donde el throughput sostenido importa más que la latencia percibida.
El mensaje de fondo se repite: sin la compresión de CompactifAI, este modelo ni siquiera llega a arrancar en este nodo; con ella, es funcional dentro de sus límites.
1. La versión de vLLM utilizada ha sido 0.18.1, debido a una restricción en la generación de algunos de los modelos comprimidos por Multiverse a los que tuvimos acceso. vLLM 0.18.1 es la última versión que depende de la rama 4.x de Transformers.
Marcos Cobeña Morián
Software Development Engineer


