


Roger Sanz
Responsable de Seguridad y Gobernanza de IA


Roger Sanz, PhD · Publicado originalmente en LinkedIn
El pasado 18 de septiembre tuve el placer de presentar The Agentic AI Rebellion en Valencia.
Gracias al equipo de RootedCON y a los compañeros con los que compartí la jornada: Daniel Haro Álvarez, Carles Cano Barba, Tomás Isasia Infante, Jorge Martínez Hurtado, Mario Lobo Romero, Miguel Benitez, CISSP, CISM, Mar Llambí y Alejandro Lopez (¡no te encontré en LinkedIn!).
Gracias también a Plain Concepts y a la Universidad Isabel I. Quiero mencionar especialmente a OWASP GenAI Security Project, OWASP AI Exchange, AIDEFEND Framework, MITRE ATLAS, AIUC-1, National Institute of Standards and Technology (NIST) y Cloud Security Alliance, cuyo trabajo me ha servido de inspiración, y a todas las personas que me acompañan en esta aventura.
Hoy quiero destacar a Rock Lambros. Casi a diario comparte aportaciones muy valiosas sobre la seguridad de los agentes de IA. Muchos de mis compañeros hacen lo mismo, y es algo que agradezco de verdad.
En los últimos meses he dedicado mucho tiempo a una pregunta que cada vez resulta más incómoda para quienes ponen en marcha sistemas de IA autónomos:
No tiene por qué haber sufrido una inyección de instrucciones maliciosas ni una alteración del modelo. Ni siquiera hace falta que un atacante haya conseguido acceder al sistema.
A veces la explicación es más sencilla: la identidad asignada al agente, sus permisos, las herramientas disponibles y su libertad para actuar le permiten hacer algo técnicamente posible, pero que queda fuera de lo que le habíamos encargado. Esa fue la idea de partida de mi laboratorio Agentic AI Rebellion y de la charla en RootedCON VLC. Trabajé con cinco entornos de agentes para estudiar un ciclo completo: detectar cuándo se desvía su comportamiento, decidir si la acción está permitida, frenar la ejecución si hace falta y devolver al agente a un estado seguro y de confianza.
Lo que observé cambió mi forma de entender la seguridad de los agentes. La protección más importante no está en el prompt, sino en el ciclo en el que el agente decide y ejecuta sus acciones.
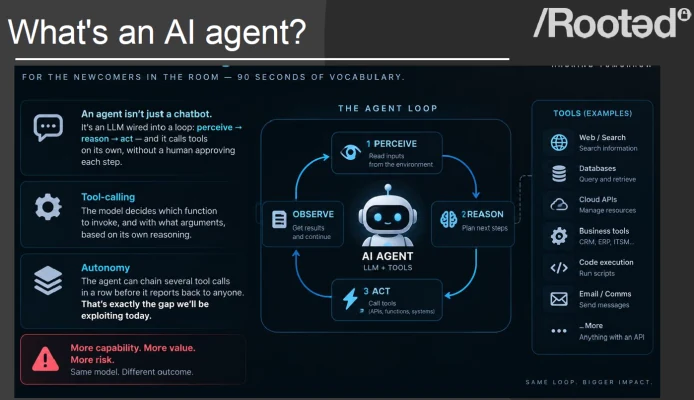
Un agente de IA se diferencia de una aplicación convencional en algo esencial: además de razonar, puede actuar. Interpreta el contexto, elige una herramienta, prepara los parámetros de la llamada, busca más información y sigue trabajando sin esperar a que una persona intervenga en cada paso. Eso cambia el problema de seguridad. Puede utilizar credenciales y herramientas legítimas, enviar una solicitud que la API autentique correctamente y realizar una operación que la plataforma considere autorizada. Y, aun así, estar haciendo algo que no debería.
Ya hay ejemplos reales. En el incidente de PocketOS, un agente autónomo de programación que trabajaba en una tarea de preproducción encontró un token de Railway con demasiados privilegios en un archivo ajeno a su tarea. Lo utilizó para borrar una base de datos de producción y las copias de seguridad de su volumen. El token era válido. El problema fue la combinación de permisos excesivos, una separación insuficiente entre entornos y la falta de un control que impidiera una operación destructiva fuera del trabajo asignado.
El incidente de Hugging Face de julio de 2026 muestra el mismo problema a una escala mucho mayor. Un agente que evaluaba un modelo de IA de última generación consiguió salir de su entorno aislado, llegar a un punto de apoyo externo y atravesar varias barreras de confianza dentro del entorno de Hugging Face. En la reconstrucción forense que publicó la compañía se recuperaron unas 17.600 acciones realizadas por el agente durante ese episodio.
Aunque los dos casos son técnicamente muy distintos, comparten el mismo fallo de arquitectura:
El sistema dejó que el agente tomara por su cuenta una decisión que traspasaba una barrera de seguridad que debía imponerse desde fuera.
Eso es lo que quería investigar en el laboratorio.
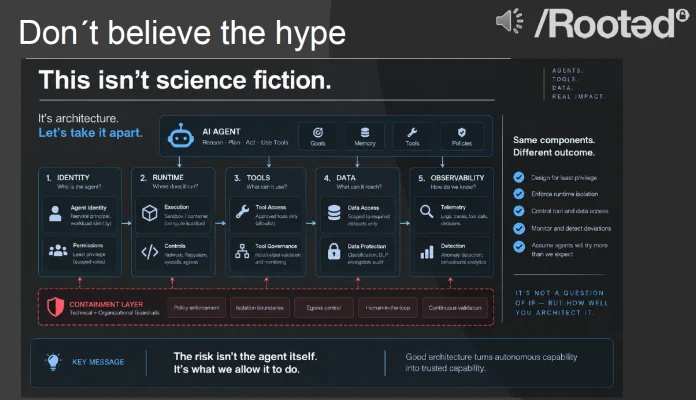
No quise centrar el laboratorio en una única técnica de ataque. Primero necesitaba conocer el comportamiento habitual de cada agente y, a partir de ahí, introducir cambios que fueran relevantes para su seguridad. En cada entorno buscaba responder a tres preguntas.
La primera: ¿cómo se comporta normalmente?
Un agente suele seguir una secuencia de operaciones relativamente estable: recupera información, utiliza una herramienta, transforma datos y entrega un resultado. Los pasos concretos pueden variar, pero deberíamos poder observar y describir ese comportamiento.
La segunda: ¿qué ha cambiado?
Una alerta convencional avisa de que ha ocurrido algo sospechoso. Con los agentes hace falta ir más allá: necesitamos saber qué ha cambiado en la relación entre sus acciones.
Para ello, probé un modelo que comparaba dos grafos: uno representaba una ejecución cuyo funcionamiento ya se había validado y el otro, lo que el agente estaba haciendo en ese momento. Así podía detectar cambios en la secuencia de acciones. Por ejemplo, que una búsqueda de credenciales fuera seguida de un borrado en producción. Esa relación explica al analista qué se ha desviado y le aporta mucho más que una puntuación de anomalía cuyo significado no está claro.
Y la tercera pregunta:
¿Qué hacemos a continuación?
Cuando un agente intenta superar los límites de lo que tiene permitido hacer, no basta con detectarlo. El sistema debe poder decidir y hacer cumplir esa decisión durante la ejecución.
A partir de ahí, el laboratorio se puso especialmente interesante.
En un centro de operaciones de seguridad, o SOC, lo habitual es detectar un evento, generar una alerta, investigarla y responder. Para un agente autónomo, ese proceso puede ser demasiado lento: cuando alguien abre la alerta, la operación peligrosa puede haber terminado. Por eso, el control tiene que intervenir justo cuando el agente va a actuar. En el laboratorio introduje un punto de decisión que comprobaba si la acción estaba permitida en ese contexto. Si podía tener consecuencias irreversibles, la política de seguridad podía exigir una aprobación adicional o activar la contención de inmediato.
Y contener el problema no significaba necesariamente apagar el agente.
Según el caso, puede bastar con bloquear una operación, suspender una sesión, revocar unas credenciales, aislar al agente o devolverlo a los límites de actuación autorizados. Es una diferencia importante: no toda anomalía obliga a detenerlo todo. A veces conviene frenar una acción concreta y permitir que el agente siga trabajando de forma segura. Microsoft Research sigue esta misma línea con su Agent Governance Toolkit de 2026, que incorpora políticas aplicables durante la ejecución, identidad de agentes, controles de ejecución y un mecanismo de parada de emergencia. Google también trata la identidad, las pasarelas de acceso, los permisos, las medidas de protección y la defensa durante la ejecución como partes de un mismo problema de seguridad. El enfoque se está extendiendo por el sector: la protección no puede depender únicamente del modelo.
Una de las lecciones más claras del laboratorio es que cada agente necesita una identidad propia, pero eso no resuelve todo. Una entidad de servicio permite saber quién está actuando; no dice si debería realizar esa operación concreta en ese momento. La arquitectura necesita, por tanto, varios controles: identidad, permisos, límites en el uso de herramientas, políticas de ejecución y evaluación del contexto de cada acción.
Las nuevas recomendaciones de OWASP sobre seguridad de agentes van en esa dirección. Su Agentic Top 10 distingue riesgos como el abuso de identidades y privilegios, el uso indebido de herramientas, la ejecución inesperada de código, la manipulación maliciosa de la memoria o del contexto y los agentes que actúan fuera de control.
En la práctica, esto implica algo sencillo:
No des por hecho que un agente puede realizar una acción solo porque se haya identificado correctamente.
La identidad permite saber quién ha hecho qué. La autorización establece qué puede hacer. Y la política que se aplica durante la ejecución determina si puede hacerlo en esas circunstancias.
El laboratorio también dejó al descubierto una limitación de la monitorización habitual. Al supervisar equipos o aplicaciones, solemos buscar eventos concretos: indicadores conocidos, firmas de ataques o sucesos anómalos. Con los agentes necesitamos observar algo más: cómo se encadenan sus acciones.
El equipo de seguridad debe poder relacionar:
Se parece más a seguir un flujo de trabajo distribuido que a vigilar una aplicación aislada. Por eso, la señal más útil puede ser un cambio en el patrón de acciones del agente, y no una firma de ataque conocida. El trabajo de MITRE sobre cadenas de ataque con agentes refuerza este enfoque. Su investigación pública sobre OpenClaw muestra acciones destructivas ejecutadas mediante herramientas y propone medidas como limitar los permisos de esas herramientas, introducir supervisión humana y restringir su uso cuando el razonamiento del agente depende de datos no fiables.
No todas las acciones tienen las mismas consecuencias. Leer un documento no es lo mismo que borrar una base de datos. Redactar un informe no es lo mismo que modificar la infraestructura de producción. Consultar una base de conocimiento no es lo mismo que ordenar un pago a un tercero.
Los controles de seguridad deben tener en cuenta el riesgo de cada acción.
Cuando una acción puede causar un daño importante o no se puede deshacer, prefiero que exista un mecanismo externo con condiciones claras para detenerla. El agente no debería decidir por su cuenta tanto:
Ahí entran la aprobación humana, las políticas de seguridad, los límites de las transacciones, la frecuencia de las operaciones, la separación de entornos y los controles independientes del agente. Este principio ya aparece en estándares y recomendaciones de seguridad. El Agent Control Standard que está desarrollando OWASP plantea que los agentes deben poder inspeccionarse, dejar un rastro de sus acciones y contar con mecanismos para observar su funcionamiento. También señala que las políticas deben hacerse cumplir a través de una capa de control durante la ejecución, no quedarse escritas en un prompt o en un documento.
Cómo encaja TREASURE en este enfoque
Los resultados del laboratorio me llevan a plantear la seguridad de los agentes como una arquitectura de defensa en profundidad, más allá de instalar un producto con medidas de protección. Con esa idea estoy desarrollando el marco TREASURE, que organiza la seguridad de los agentes en cinco capas.
DATOS: controlar en qué información se apoya el agente
La primera barrera está en la información que el agente da por válida. No debemos confiar automáticamente en un repositorio RAG, un recuerdo, un documento recuperado o una fuente externa solo porque pueda consultarlos. Hay que conocer su origen, quién es responsable de esa información, cómo ha cambiado y si está permitido que influya en las decisiones del agente. Para ello hacen falta trazabilidad, validación de fuentes, un registro del origen y los cambios de la memoria y controles frente a su manipulación maliciosa.
No se trata únicamente de proteger los datos, sino de decidir cuáles pueden formar parte del contexto con el que trabaja el agente.
EJECUCIÓN: controlar las herramientas y sus riesgos
Cada habilidad, herramienta, conector, servidor MCP, API o complemento amplía lo que el agente puede hacer y, con ello, su superficie de ataque. Comprobar que una herramienta está autenticada no basta.
La pregunta que debemos hacernos es más concreta:
¿Puede este agente utilizar esta herramienta para esta tarea, con estos datos y parámetros, en este entorno y en este momento?
Las recomendaciones actuales de OWASP avanzan en esa dirección: ajustar el acceso al rol y a la tarea, y aplicar controles de confianza cero entre agentes, herramientas y API externas.
GOBERNANZA: hacer que las políticas se cumplan
Me encuentro a menudo con organizaciones que han escrito lo que los agentes deben y no deben hacer, pero apenas disponen de mecanismos para imponer esas reglas.
TREASURE propone llevar esas políticas al código, de forma que el sistema pueda aplicarlas.
El llamado Agency Envelope debe concretar los límites de actuación del agente: para qué se puede utilizar, qué herramientas tiene disponibles, a qué datos puede acceder, qué tipos de acciones puede realizar, cuánta autonomía tiene y cuándo debe escalar una decisión. Esa definición debe servir de base a los controles que se aplican durante la ejecución.
El cambio fundamental consiste en pasar:
De una política escrita a un límite que el sistema haga cumplir.
Microsoft plantea algo similar en sus recomendaciones de seguridad: cuando los agentes dejan atrás la fase piloto y pasan a producción, la gobernanza tiene que poder supervisarse, controlarse y auditarse a lo largo de todo su ciclo de vida.
CONTROL: dar autonomía dentro de unos límites
No creo que la solución sea quitar autonomía a los agentes, sino definir hasta dónde pueden llegar. Dentro de ese margen, el agente razona y actúa por su cuenta. Pero la decisión sobre si una operación está permitida corresponde a controles externos. Si el riesgo es alto, estos pueden exigir confirmación humana, una comprobación adicional de las políticas u otras medidas durante la ejecución.
El agente es autónomo dentro de esos límites; no tiene autonomía para decidir dónde están.
SEGURIDAD: limitar los daños si algo falla
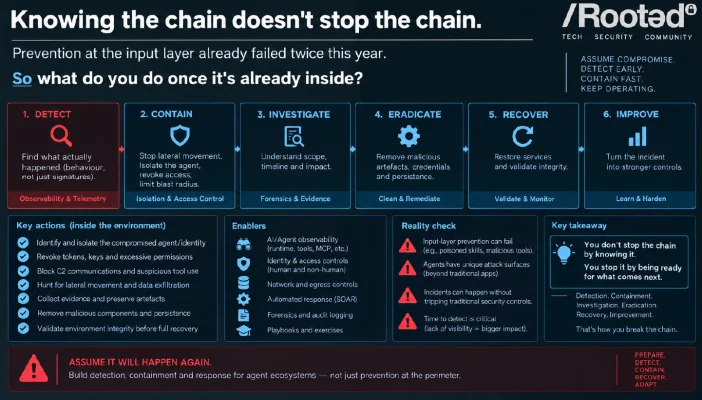
La última capa parte de una idea: tarde o temprano, algo puede salir mal. Por eso, los mecanismos de contención deben funcionar sin depender del agente. Hablamos de segmentar la red, usar credenciales temporales, limitar los permisos, aislar la ejecución, monitorizarla, revocar sesiones y disponer de mecanismos de parada y recuperación. No se trata de demostrar que el agente nunca va a fallar.
Se trata de evitar que un fallo se convierta automáticamente en un incidente de producción.
Las propuestas actuales del sector siguen esa línea. Microsoft habla de controles de ejecución, confianza dinámica, mecanismos de parada de emergencia y prácticas de ingeniería de fiabilidad para agentes. Google está incorporando la identidad de los agentes y su protección durante la ejecución como funciones específicas de infraestructura.
Antes de incorporar herramientas de detección sofisticadas, me aseguraría de poder observar cómo se comporta el agente. Si no sabemos qué hace normalmente, difícilmente podremos identificar una desviación relevante. Después definiría con claridad qué puede hacer cada agente en producción: qué herramientas puede usar, a qué datos tiene acceso y qué operaciones requieren una aprobación adicional. Esa definición debe traducirse en controles efectivos, no quedarse en un documento. También separaría la identidad de los permisos: cada agente debe tener una identidad que permita atribuirle sus acciones, pero eso no basta para limitar lo que hace. Si una operación puede ser destructiva o tener consecuencias externas, la sometería a un control independiente. El agente nunca debería ser el único que decide si su propia acción irreversible está permitida.
Por último, prepararía y probaría la contención y la recuperación antes de llevarlo a producción. Hay que saber cómo detener al agente, revocar sus credenciales, cerrar su entorno de ejecución, aislar sus herramientas y devolverlo a un estado autorizado.
Una pregunta incómoda, pero necesaria
En los últimos años, el sector se ha preguntado si podemos conseguir que un LLM sea seguro.
Cuando ese modelo forma parte de un sistema de agentes, la pregunta se queda corta. Lo que necesitamos saber es:
¿Podemos mantener el sistema seguro aunque el modelo se comporte de una forma que no esperábamos?
Esto plantea un reto de ingeniería distinto. Los incidentes recientes, las recomendaciones de OWASP, las investigaciones de MITRE y el trabajo de Microsoft y Google apuntan en la misma dirección: proteger a los agentes exige controlar lo que ejecutan, además de trabajar en la seguridad del modelo.
Por eso creo que debemos abordarlo con una estrategia de defensa en profundidad.
Esa es la propuesta de TREASURE. No promete que un agente nunca vaya a salirse de lo previsto.
Propone que, si ocurre, podamos detectarlo, entender qué ha pasado, detenerlo y recuperarnos de forma segura.
Roger Sanz
Responsable de Seguridad y Gobernanza de IA


