


Juan G. Carmona
Software Architect at Plain Concepts


Parte 1 — La definición del producto como código
Últimamente trabajo como FDE (Forward Development Engineer) en Plain Concepts, ayudando a distintos clientes a incorporar la IA a su ciclo de desarrollo de software. Mis dos principales áreas de trabajo son el ciclo de desarrollo con IA (AI-SDLC) y el desarrollo guiado por especificaciones (Spec-Driven Development, o SDD). Eso me ha llevado a pensar mucho en las implicaciones del desarrollo asistido por IA, en entornos muy distintos, con herramientas, flujos de trabajo y situaciones de todo tipo.
A medida que cambian las tecnologías, las organizaciones y sus limitaciones, hay algo que se repite: la mayoría de los problemas son problemas de documentación. Sinceramente, no debería sorprendernos. La documentación y su gestión siempre han sido un desastre en el sector del software. Y decir «desastre» es ser bastante amable.
La IA está sacando a la luz viejos problemas
Durante años, los equipos de software han salido adelante con el conocimiento disperso:
Esto ya era ineficiente cuando las personas se encargaban de casi toda la implementación. Con el desarrollo asistido por IA, se convierte en un problema estructural.
Cuando la definición del producto está incompleta, se contradice o se reparte entre varias herramientas y la memoria de distintas personas, la IA hace lo mismo que siempre han hecho los ingenieros: intenta adivinar. Y, al hacerlo, se desvía y comete errores.
Es el mismo problema de desviación del que hablaba en Spec-Driven Development: Controlling AI-Generated Drift. El SDD lo aborda desde la implementación. Este artículo retrocede un paso más en el proceso, hasta el momento en que la especificación todavía no existe.
Miremos lo que ocurre antes del desarrollo
Normalmente representamos el ciclo de vida del desarrollo de software de izquierda a derecha:
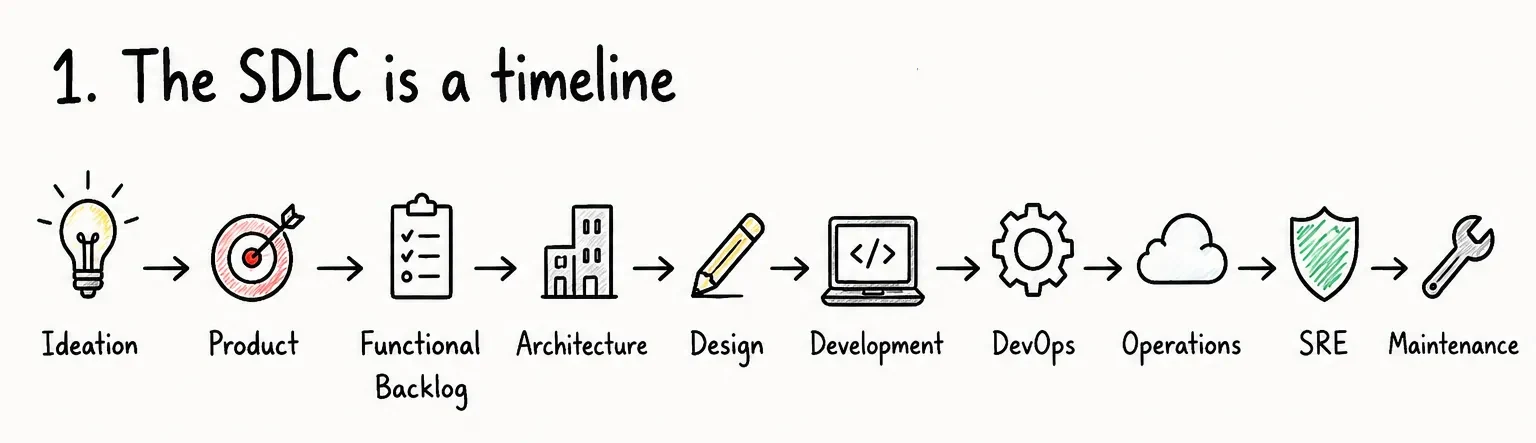
Los nombres de las etapas cambian según la organización, pero la dirección siempre es la misma: de las ideas abstractas a una implementación concreta, y de ahí a producción y mantenimiento.
Hoy, la mayor parte del esfuerzo en ingeniería con IA se concentra en el desarrollo y en las actividades que lo rodean: generación de código, pruebas, revisión de código, refactorización, CI/CD, infraestructura, análisis de incidencias y mantenimiento. Todo ello es útil, pero se sitúa en el centro y a la derecha del ciclo.
A medida que se automatiza la implementación, el cuello de botella se desplaza hacia la izquierda. También hacia la derecha, pero esa es otra historia.
Ahora las preguntas difíciles son otras: para quién es el producto, qué quiere conseguir esa persona, cómo debería comportarse el sistema, qué reglas rigen ese comportamiento, qué significa el lenguaje del dominio, qué requisitos se desprenden de esas decisiones y qué estamos pidiendo exactamente a la IA que cambie.
Hoy quiero centrarme ahí, en lo que ocurre antes del desarrollo, porque los elementos que entran en esa fase son los artefactos de producto que definen qué vamos a construir.
Dónde se concentra hoy la inversión en IA
La mayor parte del esfuerzo en IA se concentra hoy en desarrollo, DevOps y operaciones: asistentes de programación, generadores de pruebas, bots de revisión, copilotos de integración continua y analizadores de incidencias. Todos se sitúan en la mitad derecha de esa línea temporal.
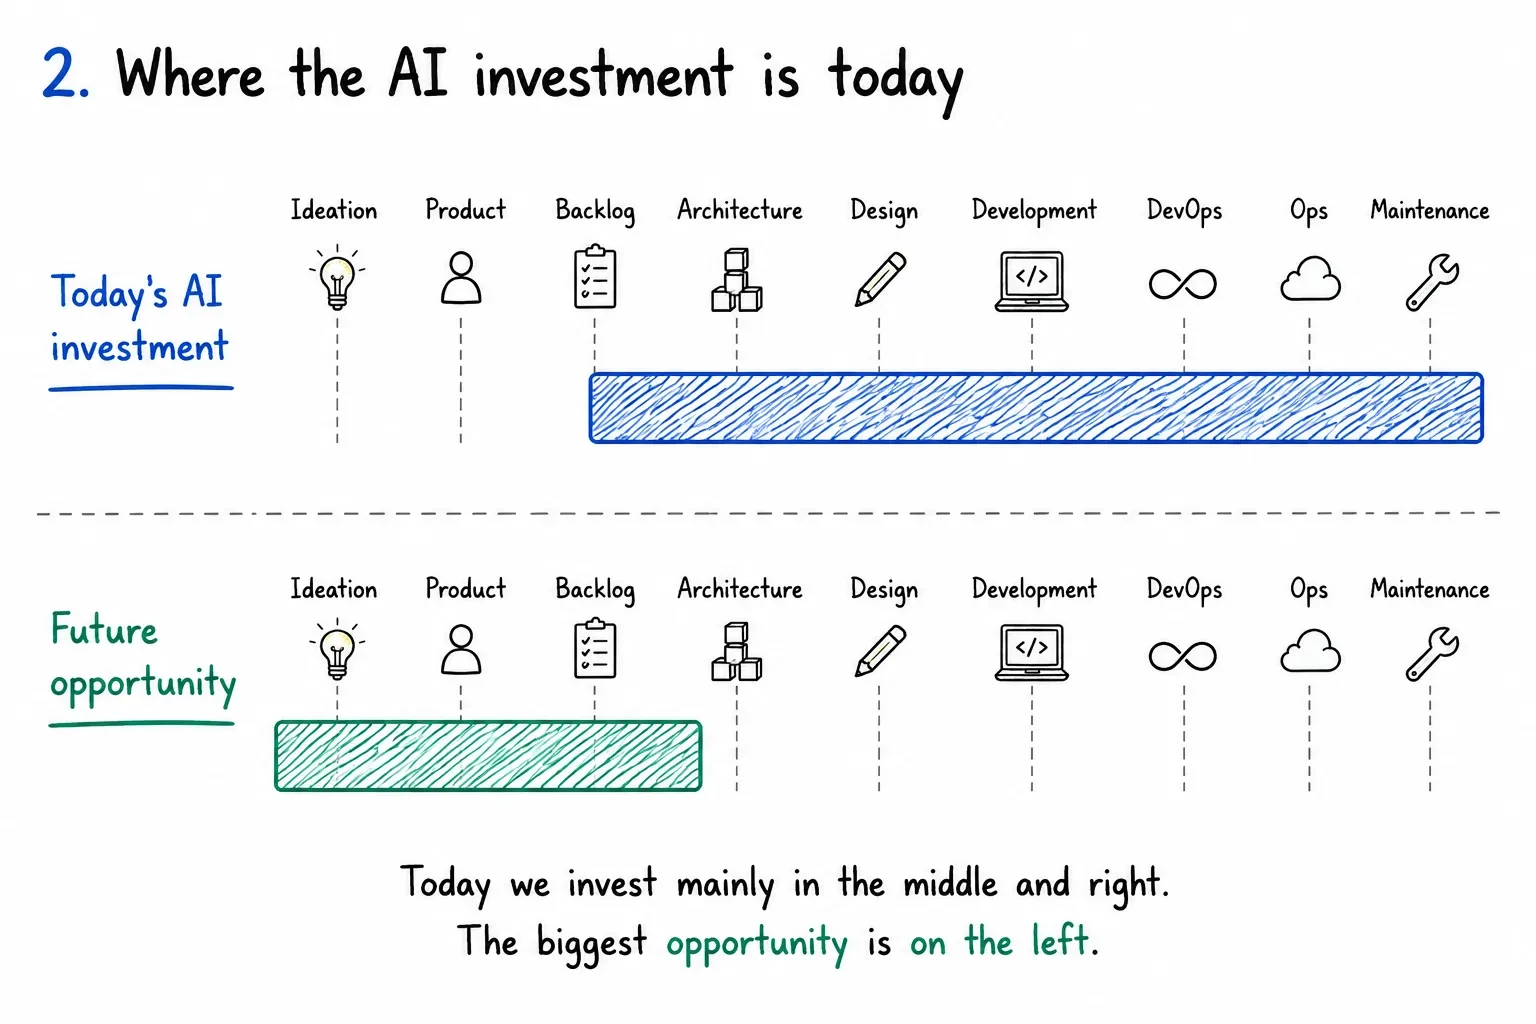
Era más fácil demostrar el retorno de la inversión en esas actividades, así que el sector empezó por ahí. Tiene sentido.
Pero ese terreno está ya muy explorado. La siguiente gran oportunidad está en el lado izquierdo del ciclo: donde se decide qué se quiere conseguir con el producto, se define el lenguaje y nacen los requisitos. Ahí empiezan los malentendidos, tanto de las personas como de la IA, las desviaciones y el esfuerzo desperdiciado.
Esa parte es más difícil. Es más desordenada, está menos estructurada y, hasta ahora, se ha basado en personas hablando con otras personas. Precisamente por eso ha sido tan difícil automatizarla.
Por qué cuesta tanto automatizar la definición del producto
Porque el conocimiento del producto está fragmentado.
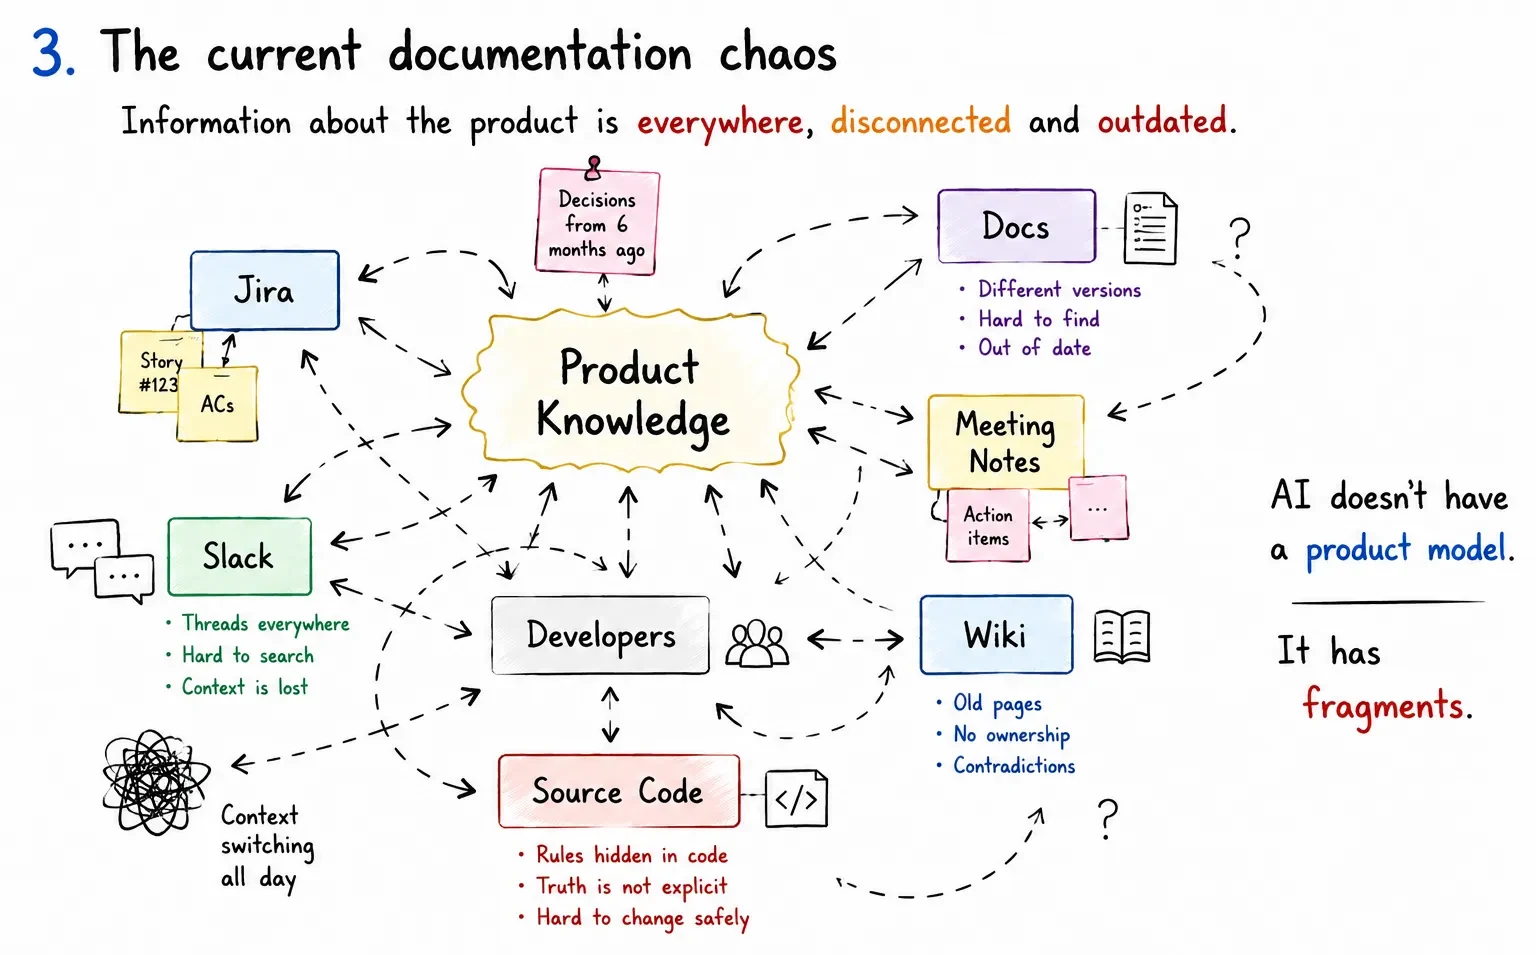
Las decisiones sobre el producto están en Jira. Las conversaciones, en Slack o Teams. Los razonamientos extensos, con suerte, en Docs; otras veces, en páginas caóticas de Confluence. La mitad de todo eso se queda en reuniones sin acta. El resto vive en comentarios del código y en la cabeza de dos ingenieros sénior a punto de jubilarse y un tercero que suele estar de vacaciones.
La IA no dispone de un modelo del producto. Le damos fragmentos continuamente, y esos fragmentos son «ruido» que tiene que recomponer para extraer algo comprensible en cada invocación. Nada garantiza que llegue dos veces a la misma interpretación. Es justo lo contrario del determinismo que buscamos como referencia en el AI-SDLC.
Esta es la causa de fondo de lo que planteaba en The Missing Standard Behind AI-Assisted Development. Allí la fragmentación estaba en las herramientas: cada proveedor buscaba sus propios archivos. Aquí el problema es más profundo. Está en el conocimiento del producto, antes de que se ejecute ninguna herramienta.
No podemos estandarizar cómo descubrir ese conocimiento si no existe una fuente de referencia que descubrir.
La propuesta de definir el producto como código
La palabra que sigo usando, a propósito poco elegante, es artifacting: convertir el conocimiento en artefactos.
En vez de tratar lo que sabemos del producto como una colección de conversaciones, tickets y documentos, podemos representar sus distintas dimensiones mediante artefactos explícitos, versionados y relacionados entre sí. No hace falta un documento gigantesco ni una especificación de 200 páginas que nadie lee, sino un grafo de artefactos pequeños, cada uno centrado en un aspecto del producto.
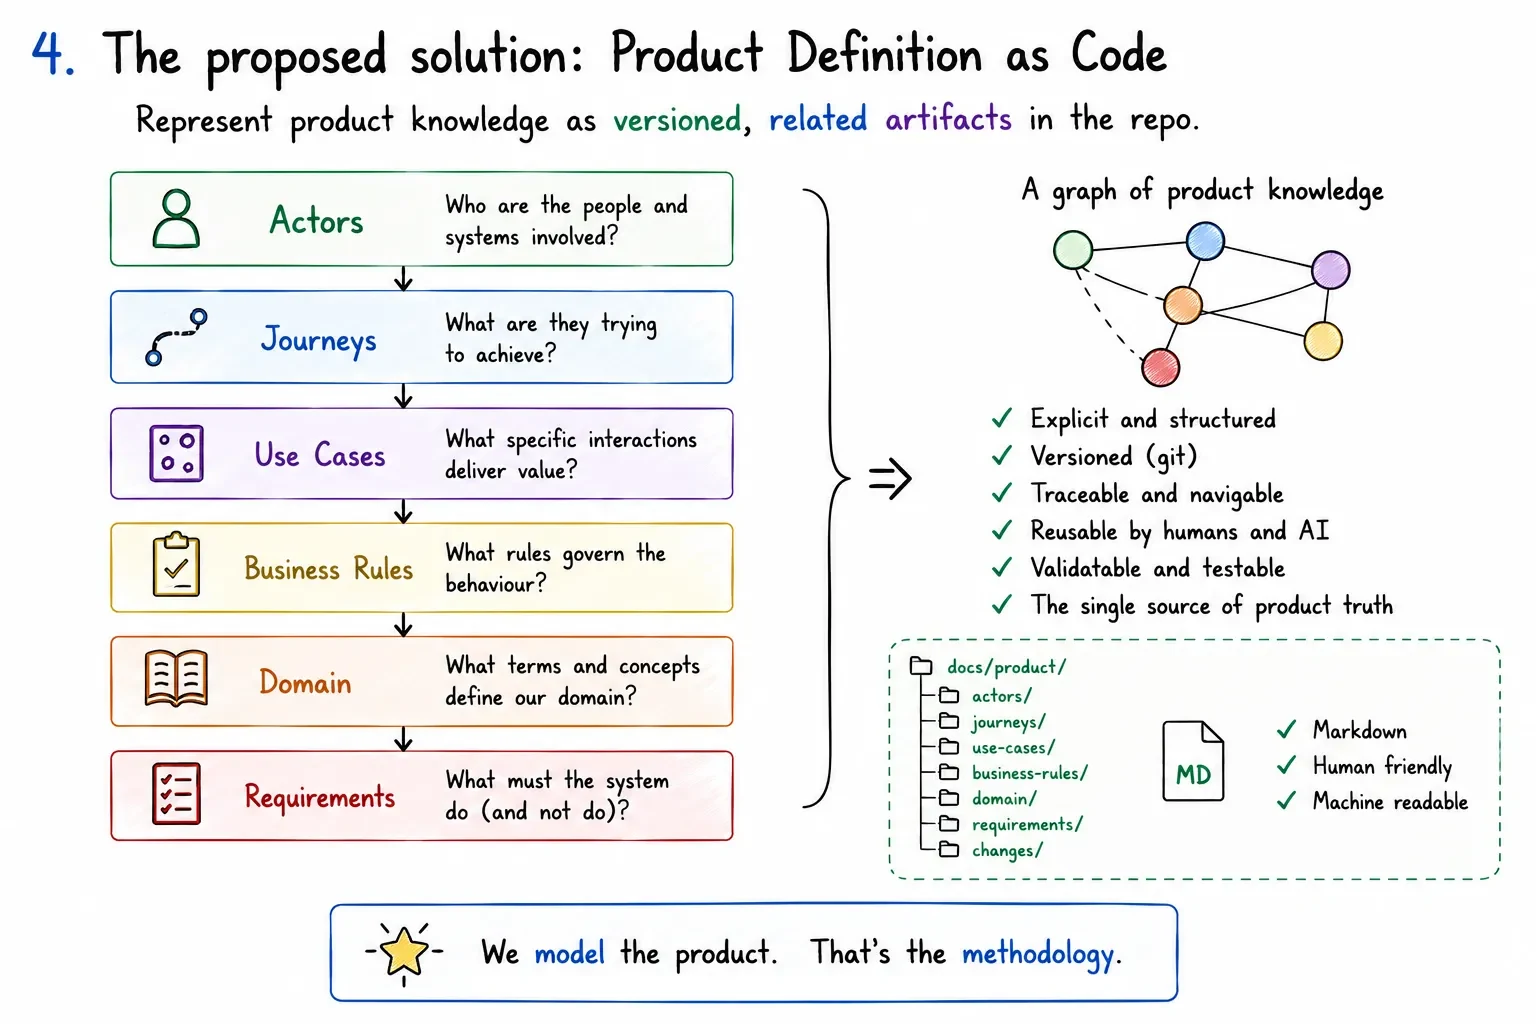
Hace poco probé este enfoque de forma manual con bastantes clientes y funcionó. En general, los artefactos son:
Un actor participa en un recorrido. Ese recorrido contiene casos de uso. Cada caso de uso se rige por reglas de negocio. Las reglas de negocio y los conceptos del dominio dan lugar a requisitos, tanto funcionales como no funcionales.
Los documentos resultaron útiles, pero la verdadera metodología está en las relaciones entre ellos. Esas relaciones permiten recorrer el conocimiento del producto, seguir su trazabilidad y utilizarlo, tanto a las personas como a la IA.
El nombre provisional de esta idea es Product Definition as Code, o definición del producto como código.
Todo es código. O puede llegar a serlo.
No es un eslogan, sino una postura de ingeniería. Si algo se puede escribir, se puede versionar. Si se puede versionar, se puede validar. Y si se puede validar, podemos examinar su estructura y sus incoherencias. Ahí empieza la confianza, pero no termina: sigue haciendo falta una revisión de la que alguien se responsabilice y, más adelante, pruebas de que se ha entregado lo previsto. El conocimiento del producto no es una excepción. En cuanto dejamos de tratarlo como una conversación pasajera y lo convertimos en un artefacto de pleno derecho, con identidad, relaciones y ciclo de vida, pasa a ser código. Y el código es precisamente lo que nuestras herramientas ya saben manejar.
Principios básicos de Product Definition as Code
No se trata de documentar por documentar. El objetivo es disponer de un contexto fiable del producto que se pueda examinar, validar, modificar y trasladar a un flujo de desarrollo asistido por IA.
Separar las responsabilidades
Una petición del Product Owner no debería convertirse de inmediato en una historia de usuario.
Antes debería convertirse en un cambio de producto (Product Change).
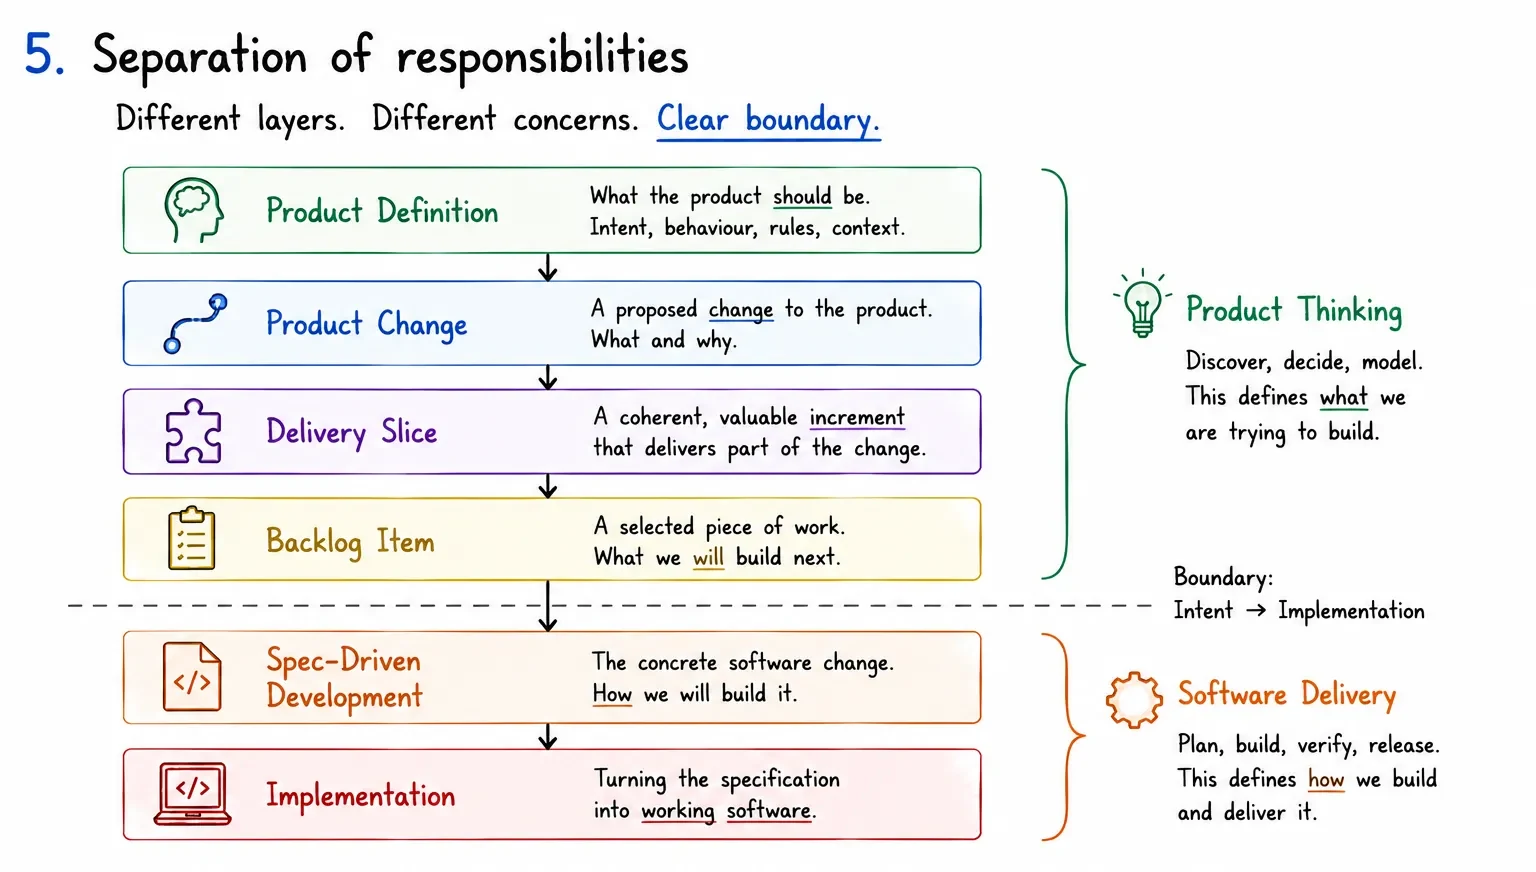
Ese cambio identifica a qué actores afecta, qué recorridos modifica, qué casos de uso añade o altera, qué reglas de negocio se aplican, qué requisitos introduce y qué preguntas siguen sin respuesta. Solo entonces debería dividirse en incrementos de entrega coherentes y trasladarse al backlog.
Así se establece una separación clara.
La definición del producto determina qué debe existir. El desarrollo guiado por especificaciones determina cómo se va a construir.
Cuando esa separación no existe, el backlog acaba convirtiéndose, sin que nadie lo decida, en la definición del producto. Y el backlog es un lugar pésimo para modelar un producto.
Esto no es otro framework de SDD. Ya existen propuestas útiles, como OpenSpec y Spec Kit, de las que hablé en Moving Toward Spec-Driven Development. Product Definition as Code está pensado para situarse antes. Genera un paquete de traspaso estable con el subgrafo del producto que necesita un incremento de entrega, mientras el entorno de SDD mantiene la estructura propia del framework elegido.
La autoridad fluye deliberadamente en un solo sentido; el aprendizaje, en ambos. El conocimiento del producto guía la entrega. Durante la entrega pueden aparecer contradicciones o información que falta, y esos hallazgos vuelven como evidencias y propuestas de cambio. Lo que no debe ocurrir es que se reescriba la definición del producto sin hacerlo explícito.
Cómo cambia nuestra forma de desarrollar software
¿Cómo sería la ingeniería de software si adoptamos este enfoque?
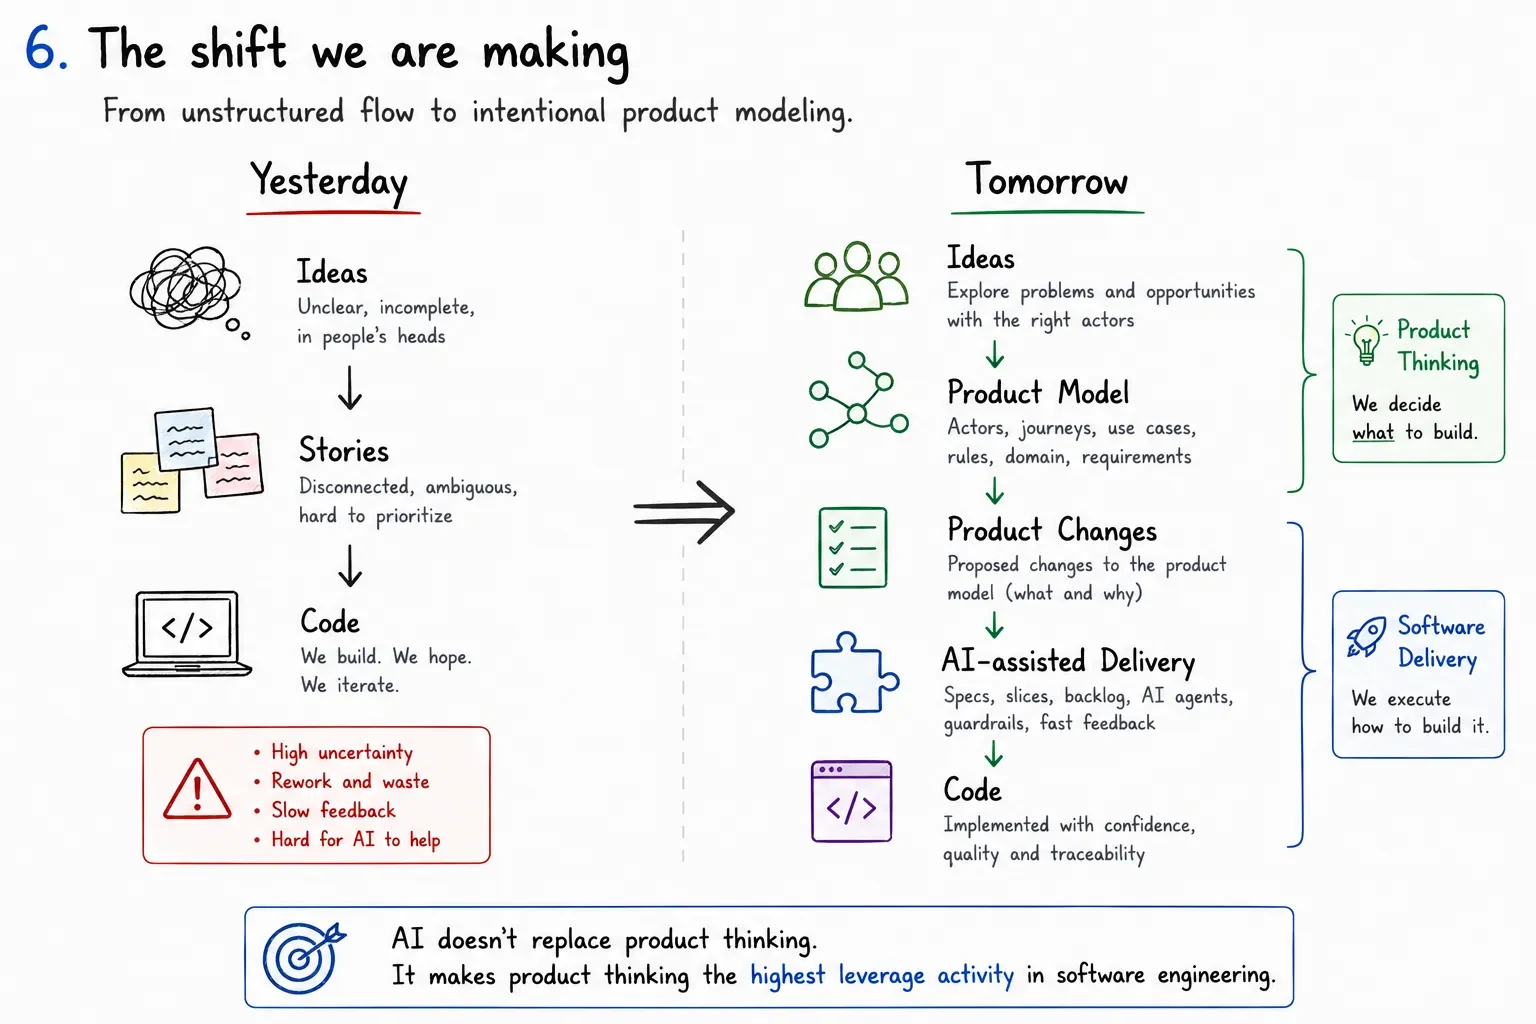
En 2026, dentro del AI-SDLC, lo más costoso ha pasado a ser construir un modelo coherente, versionado y procesable por herramientas de lo que el producto es y de lo que está pasando a ser.
Con la IA, pensar bien el producto se convierte en la actividad con mayor impacto de la ingeniería de software.
Ese es el cambio. No se trata de que «la IA sustituya a los ingenieros». La IA sustituye la capa de traducción entre lo que se quiere conseguir y su implementación. Por eso, la calidad con la que se define esa intención pasa a ser el factor limitante.
Un requisito ambiguo en manos de un ingeniero puede dar lugar a unas cuantas preguntas y retrasar la implementación. Ese mismo requisito, en un flujo de desarrollo autónomo, puede acabar en cincuenta archivos modificados, una abstracción nueva y extraña, un par de desajustes de arquitectura que nadie detectó a primera vista, seis pruebas y un malentendido impecablemente implementado.
Cuanto mejor sea el contexto del producto, mejor funcionará el ciclo de desarrollo.
Eso ya supone una mejora considerable, con IA o sin ella. 🙂
La metodología en pocas palabras
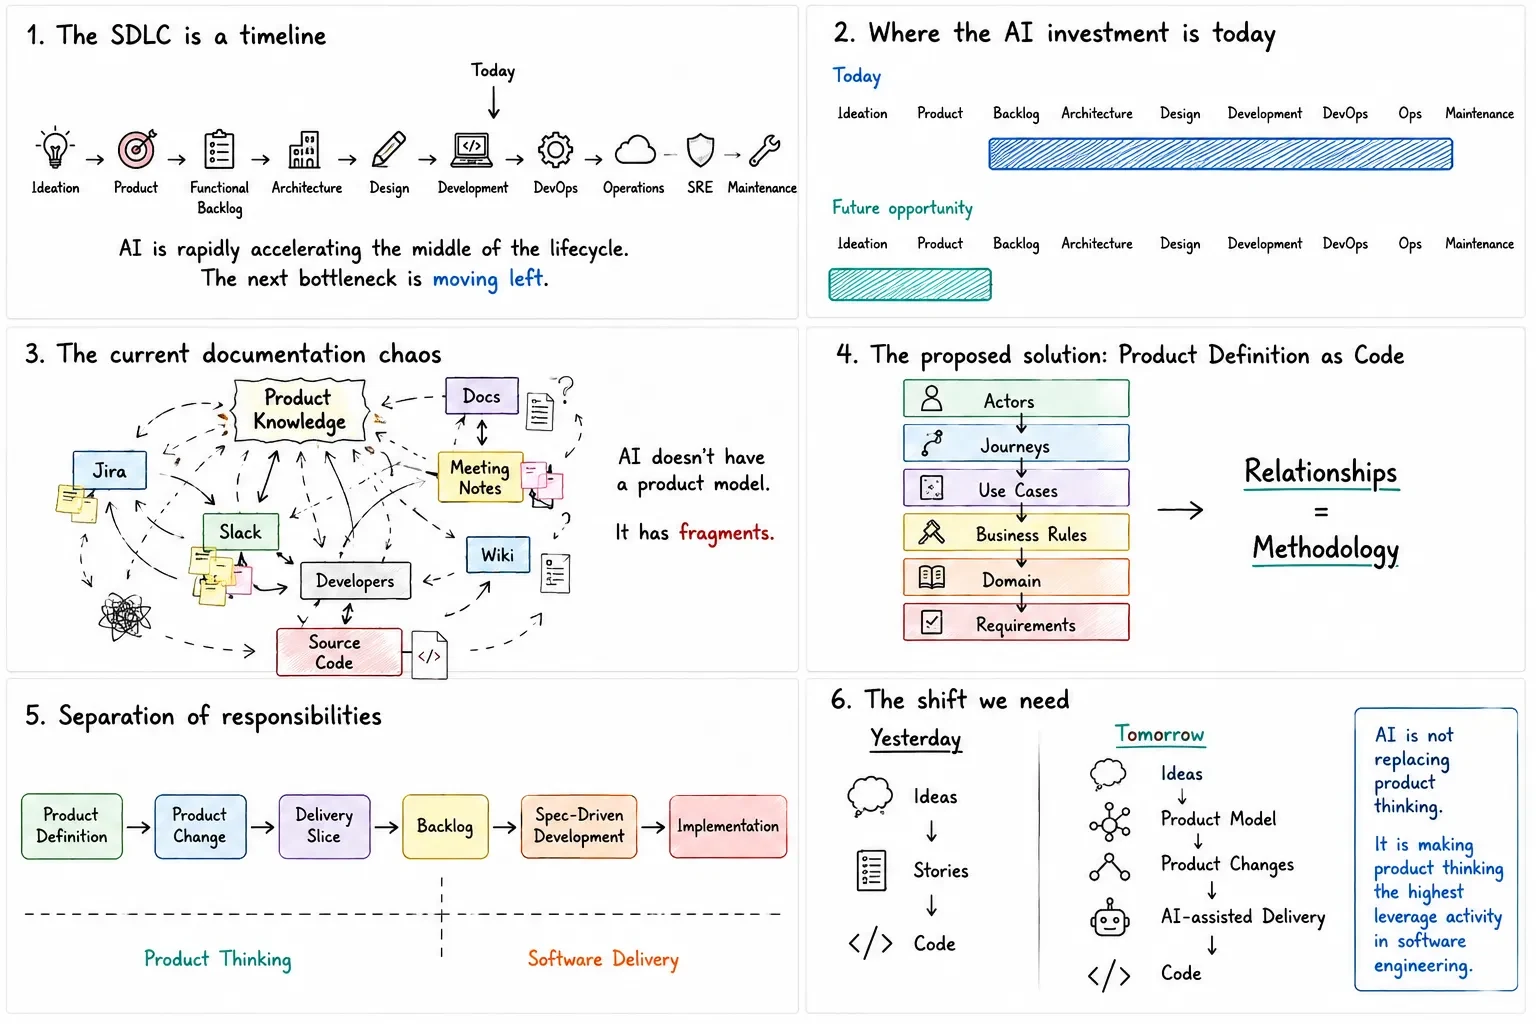
La primera versión no tiene que resolver todo el ciclo de vida del producto. Tiene que demostrar una idea:
Un grafo versionado de artefactos de producto puede ofrecer un mejor contexto a las personas y a la IA antes de empezar a implementar el software.
Parte 2 — ProductShape, la implementación de referencia
No quería quedarme en la idea, así que construí algo a partir de ella que ahora quiero compartir.
ProductShape es la implementación de referencia de la metodología Product Definition as Code. Su relación con esta metodología es la misma que tiene OpenSpec con el desarrollo guiado por especificaciones: es un conjunto de herramientas en TypeScript que sitúa una definición canónica, versionada y validable automáticamente del producto antes del backlog y del flujo de trabajo que elijas, ya sea con IA, con agentes o con SDD.
Ha sido un ejercicio especialmente interesante porque el repositorio se define a sí mismo con su propia metodología: 59 artefactos y ningún diagnóstico de validación. Ya ha completado el ciclo de un cambio real de producto, desde la propuesta hasta su incorporación al modelo de referencia, pasando por el traspaso a un cambio nativo de OpenSpec. La versión 0.1 está terminada y publicada.
Los paquetes y su instalación
Todo está publicado en npm bajo el ámbito @prodshape. Los paquetes se versionan de forma independiente con Changesets y se publican desde GitHub Actions con verificación de procedencia. Son seis paquetes, cada uno con una función:
| Paquete | Función |
|---|---|
@prodshape/cli |
La herramienta de línea de comandos prodshape, que incluye los demás paquetes. |
@prodshape/core |
Análisis, validación y compilación del grafo de forma determinista. |
@prodshape/distribution |
init, generación de recursos para los proveedores y doctor. |
@prodshape/adapter-openspec |
Adaptador de OpenSpec y validación de cobertura. |
@prodshape/integration-claude |
Generación de archivos para Claude Code a partir de los recursos canónicos. |
@prodshape/integration-copilot |
Generación de archivos para GitHub Copilot a partir de los recursos canónicos. |
Puedes instalarlo de forma global:
npm install -g @prodshape/cliO ejecutarlo una vez sin instalarlo:
pnpm dlx @prodshape/cli --helpLa CLI incluye dos ejecutables equivalentes: prodshape, el principal, y product-definition, un alias de la versión 0.x que produce exactamente la misma salida y se eliminará antes de la versión 1. Los comandos de referencia son /product:*; /ps:* es solo una abreviatura opcional para quienes, como yo, preferimos teclear menos.
El modelo de artefactos
El modelo del producto es un conjunto de artefactos en Markdown, cada uno con un identificador estable e inmutable. No voy a reproducir aquí toda la tabla, porque el README del repositorio ya lo explica mejor. Sus elementos son: actores, recorridos, casos de uso, reglas de negocio, términos del dominio, contextos delimitados (bounded contexts), requisitos funcionales, requisitos de calidad y restricciones. A ellos se suman tres tipos de artefactos que gestionan el flujo de cambios: cambios de producto (Product Changes, CHG-), incrementos de entrega (Delivery Slices, SLI-) y paquetes de traspaso (Product Handoffs, HOF-).
Lo que más me gusta es que cada relación se declara una sola vez, en un único sentido y en un solo artefacto. A partir de esas declaraciones, el compilador construye el grafo completo y obtiene automáticamente las vistas inversas: los términos que pertenecen a un contexto delimitado, los elementos que utilizan una regla o los requisitos derivados de un caso de uso. Así, nadie tiene que mantener a mano referencias recíprocas.
Además, la validación del grafo es determinista: las referencias sin resolver, los tipos de destino no permitidos, los identificadores duplicados y las infracciones del ciclo de vida generan errores con códigos estables. Sin magia ni suposiciones.
Cómo adoptarlo en un producto nuevo
Este es el caso más sencillo: un repositorio nuevo, sin comportamientos acumulados que haya que reconstruir. Inicializas la estructura, elaboras el modelo de referencia inicial, lo validas y tramitas el primer cambio de producto.
1. Inicializar.
prodshape init --ai claude --sdd openspecEsto crea docs/product/, donde vive el modelo canónico, y .product/, que contiene la configuración, el grafo generado y la caché. Si has solicitado integraciones con IA, también genera archivos gestionados en .claude/ o .github/, skills, comandos /product:* y hooks. Estos archivos se generan a partir de los recursos canónicos y nunca deben editarse a mano.
2. Elaborar el modelo de referencia inicial.
La operación Define genera la primera versión del modelo del producto. Puedes hacerlo de dos maneras: con la skill define-product, que utiliza la IA para preguntarte por el producto y preparar artefactos ajustados al esquema para que los revises, o a mano a partir de templates/, donde cada tipo de artefacto dispone de una plantilla válida. La IA redacta; tú decides.
Como las relaciones apuntan a elementos definidos antes, un orden de trabajo práctico es: actores → contextos delimitados y términos del dominio → casos de uso y recorridos → reglas de negocio → requisitos funcionales, requisitos de calidad y restricciones.
3. La excepción del arranque.
El primer modelo de referencia se puede crear directamente en docs/product/model, sin tramitar un Product Change. Es la única ocasión en la que se permite editar el modelo directamente. Una vez aceptado ese punto de partida, cualquier cambio posterior en su significado debe pasar por un Product Change.
4. Validar.
prodshape validate
prodshape graph --format mermaid
prodshape inspect UC-EXAMPLE-001
prodshape impact BR-EXAMPLE-001 --direction incoming
La validación es determinista: comprueba el cumplimiento del esquema, las reglas de identificadores y prefijos, la resolución de referencias, los tipos de destino de las relaciones, las interacciones entre ciclos de vida y las secciones obligatorias del contenido. Utiliza códigos de diagnóstico estables, de PRODUCT001 a PRODUCT110. Los errores bloquean el proceso; las advertencias informan.
Cómo adoptarlo en un producto existente
Este es el escenario más habitual: un software que ya tiene comportamientos, usuarios y decisiones acumuladas, pero carece de un modelo canónico del producto. El proceso consiste en inicializar la estructura, reconstruir un modelo a partir de evidencias, validarlo como referencia y, a partir de ahí, trabajar mediante cambios de producto.
1. Inicializar. Se utiliza el mismo comando. Crea docs/product/ y .product/ sin tocar nada más: ni el código fuente, ni la compilación, ni la documentación existente.
2. Reconstruir un modelo candidato. La operación Recover reconstruye el conocimiento del producto a partir de lo que el sistema ya nos permite observar. Las fuentes de evidencia incluyen el código y las pruebas, los contratos de las API, los flujos de la interfaz, las restricciones de la base de datos, la documentación existente, los sistemas de seguimiento de incidencias, las conversaciones de soporte y, a menudo como fuente más valiosa, las entrevistas con quienes operan el sistema.
Los candidatos registran su procedencia y nivel de confianza. Cada artefacto recuperado es un borrador que indica de dónde sale ese conocimiento y cuánta confianza merece la reconstrucción. No es lo mismo extraer una regla de negocio directamente de una prueba de validación que deducirla a partir del nombre de una variable. El artefacto debe dejar clara esa diferencia.
Antes de activar nada, una persona lo valida. Los candidatos entran en el modelo con estado draft. Alguien que conozca el producto revisa cada uno, lo confirma, lo corrige o lo descarta antes de pasarlo a active. El conocimiento reconstruido nunca se convierte automáticamente en la referencia oficial: la herramienta propone y la persona decide. Esta separación es deliberada y permanente.
3. Establecer el modelo de referencia. Los candidatos validados se incorporan directamente a docs/product/model como primera versión aceptada del modelo. Después hay que validarla. Advertencias como PRODUCT105, una regla de negocio que ningún elemento utiliza, o PRODUCT103, un requisito al que no se llega desde ningún actor, son habituales en los modelos reconstruidos. Suelen señalar conocimiento cuyas relaciones aún no hemos completado.
4. Ajustar las expectativas a la realidad. La reconstrucción es gradual: no necesitas modelar todo el sistema para que esa primera referencia sea útil. Empieza por las áreas que vayas a modificar. El modelo recoge lo que hace el producto, no cómo está organizado el código. Y parte del conocimiento, sencillamente, se ha perdido. Si nadie puede confirmar por qué existe una regla, registra lo que se puede observar y deja constancia de la incertidumbre, en lugar de inventar una justificación.
5. Trabajar mediante cambios de producto. Una vez aceptado el modelo de referencia, termina la excepción del arranque. Toda evolución posterior sigue el mismo flujo de cambios que en un producto nuevo.
El ciclo de los cambios de producto
Desde que se acepta el modelo de referencia, nada lo modifica de forma implícita. Cada evolución es un Product Change: un conjunto validado de diferencias que incluye su justificación, las operaciones necesarias y los artefactos completos del estado futuro que se propone.
Todo el ciclo queda explícito de principio a fin:
Definición del producto → Cambio de producto → Incremento de entrega → Elemento del backlog
  → Paquete de traspaso → Flujo de SDD → Implementación → Verificación → Incorporación al modelo
1. Proponer. Crea un change.md con el problema, el resultado esperado, la justificación y las operaciones (add/modify/remove), junto con los artefactos completos del estado futuro propuesto. La skill analyze-product-change ayuda a prepararlo.
2. Validar sobre el modelo de referencia. El cambio se valida como una capa superpuesta al modelo, sin modificarlo. prodshape change validate CHG-EXAMPLE-001 comprueba que el estado futuro propuesto sea coherente y que todas las operaciones sean válidas respecto al modelo actual.
3. Dividir en incrementos. Tras la aprobación, el cambio se divide en incrementos de producto que puedan implementarse y verificarse, con una relación explícita de los requisitos que cubre cada uno. La skill slice-product-change ayuda en este paso.
4. Traspasar al desarrollo. Cada incremento se traduce en un elemento del backlog y genera un Product Handoff: un paquete independiente del framework que contiene exactamente el subgrafo del producto que necesita ese incremento. Incluye huellas del contenido para detectar si algún artefacto ha quedado desactualizado. El framework de SDD consume ese paquete y ejecuta su flujo habitual sin cambios. Con el adaptador de OpenSpec, el paquete se incorpora como archivos complementarios dentro de un cambio normal de OpenSpec. Su ciclo de vida se mantiene intacto y archivar un cambio nunca implica incorporarlo al modelo de referencia.
5. Implementar y verificar. El flujo de SDD realiza la implementación y se recopilan evidencias de la cobertura de los requisitos.
6. Incorporar el cambio al modelo. Cuando todos los incrementos están terminados o se han cancelado expresamente, y existen evidencias de cobertura, una persona ejecuta de forma explícita la promoción del Product Change. Primero, prodshape change promote CHG-EXAMPLE-001 --dry-run; después, el mismo comando sin --dry-run. Esta operación aplica los cambios al modelo de referencia y mueve el cambio a completed/. Nunca se activa de forma implícita.
Esta es la parte que más me importa. Toda la cadena es determinista, trazable y auditable. No hay reescrituras silenciosas ni desviaciones entre lo que se pidió, lo que se especificó, lo que se implementó y lo que hoy refleja el modelo del producto.
Estado actual y límites de la versión 0.1
La versión 0.1 se desarrolló de forma abierta mediante cuatro cambios de OpenSpec, todos completados: los fundamentos de la metodología, el núcleo del grafo, el ciclo de cambios y traspasos, y las integraciones con IA y SDD. Los paquetes ya están publicados. La implementación de referencia adoptó el nombre ProductShape mediante su propia operación de cambio (CHG-BRAND-001). La metodología conserva el nombre Product Definition as Code.
La versión 0.1 deja fuera deliberadamente las bases de datos de grafos, las interfaces web, los servidores MCP, la integración con Jira, los grafos que abarcan varios repositorios, la reconstrucción automática del modelo en sistemas existentes, las hojas de ruta y los OKR, los servicios alojados y la telemetría. La lista completa está en las limitaciones de la versión 0.1.
Busco personas que ayuden a mantener el proyecto
ProductShape está en la versión 0.1. Funciona, puede ejecutarse en infraestructura propia y ha demostrado su idea central en un repositorio real. Pero una metodología solo tiene valor si funciona también con el código, los dominios y las limitaciones de otras personas.
Busco personas interesadas en la parte del ciclo anterior al desarrollo, ya sean ingenieros de producto, arquitectos, profesionales de SDD o creadores de herramientas, que quieran ponerla a prueba con productos reales y ayudar a dar forma a la versión 0.2.
Si trabajas con OpenSpec o Spec Kit y has notado que falta algo antes de llegar a la especificación, esto te interesa. Si has intentado dar contexto de producto a un agente de IA y has visto cómo se inventaba un modelo a partir de fragmentos, este es el problema que quiero resolver.
Lee el manifiesto. Prueba la CLI. Abre una incidencia. Colabora.
La especificación establece las reglas. docs/product es la fuente de referencia. Los cambios en la propia definición del producto pasan por su operación de cambio. Aquí, usar nuestras propias herramientas no es un argumento de marketing: es la única forma en que evoluciona el repositorio.
Referencias
@prodshape.
